온디바이스 AI와 차세대 NPU 밸류체인 - 단말기 자체 AI 추론 기술과 글로벌 반도체 생태계
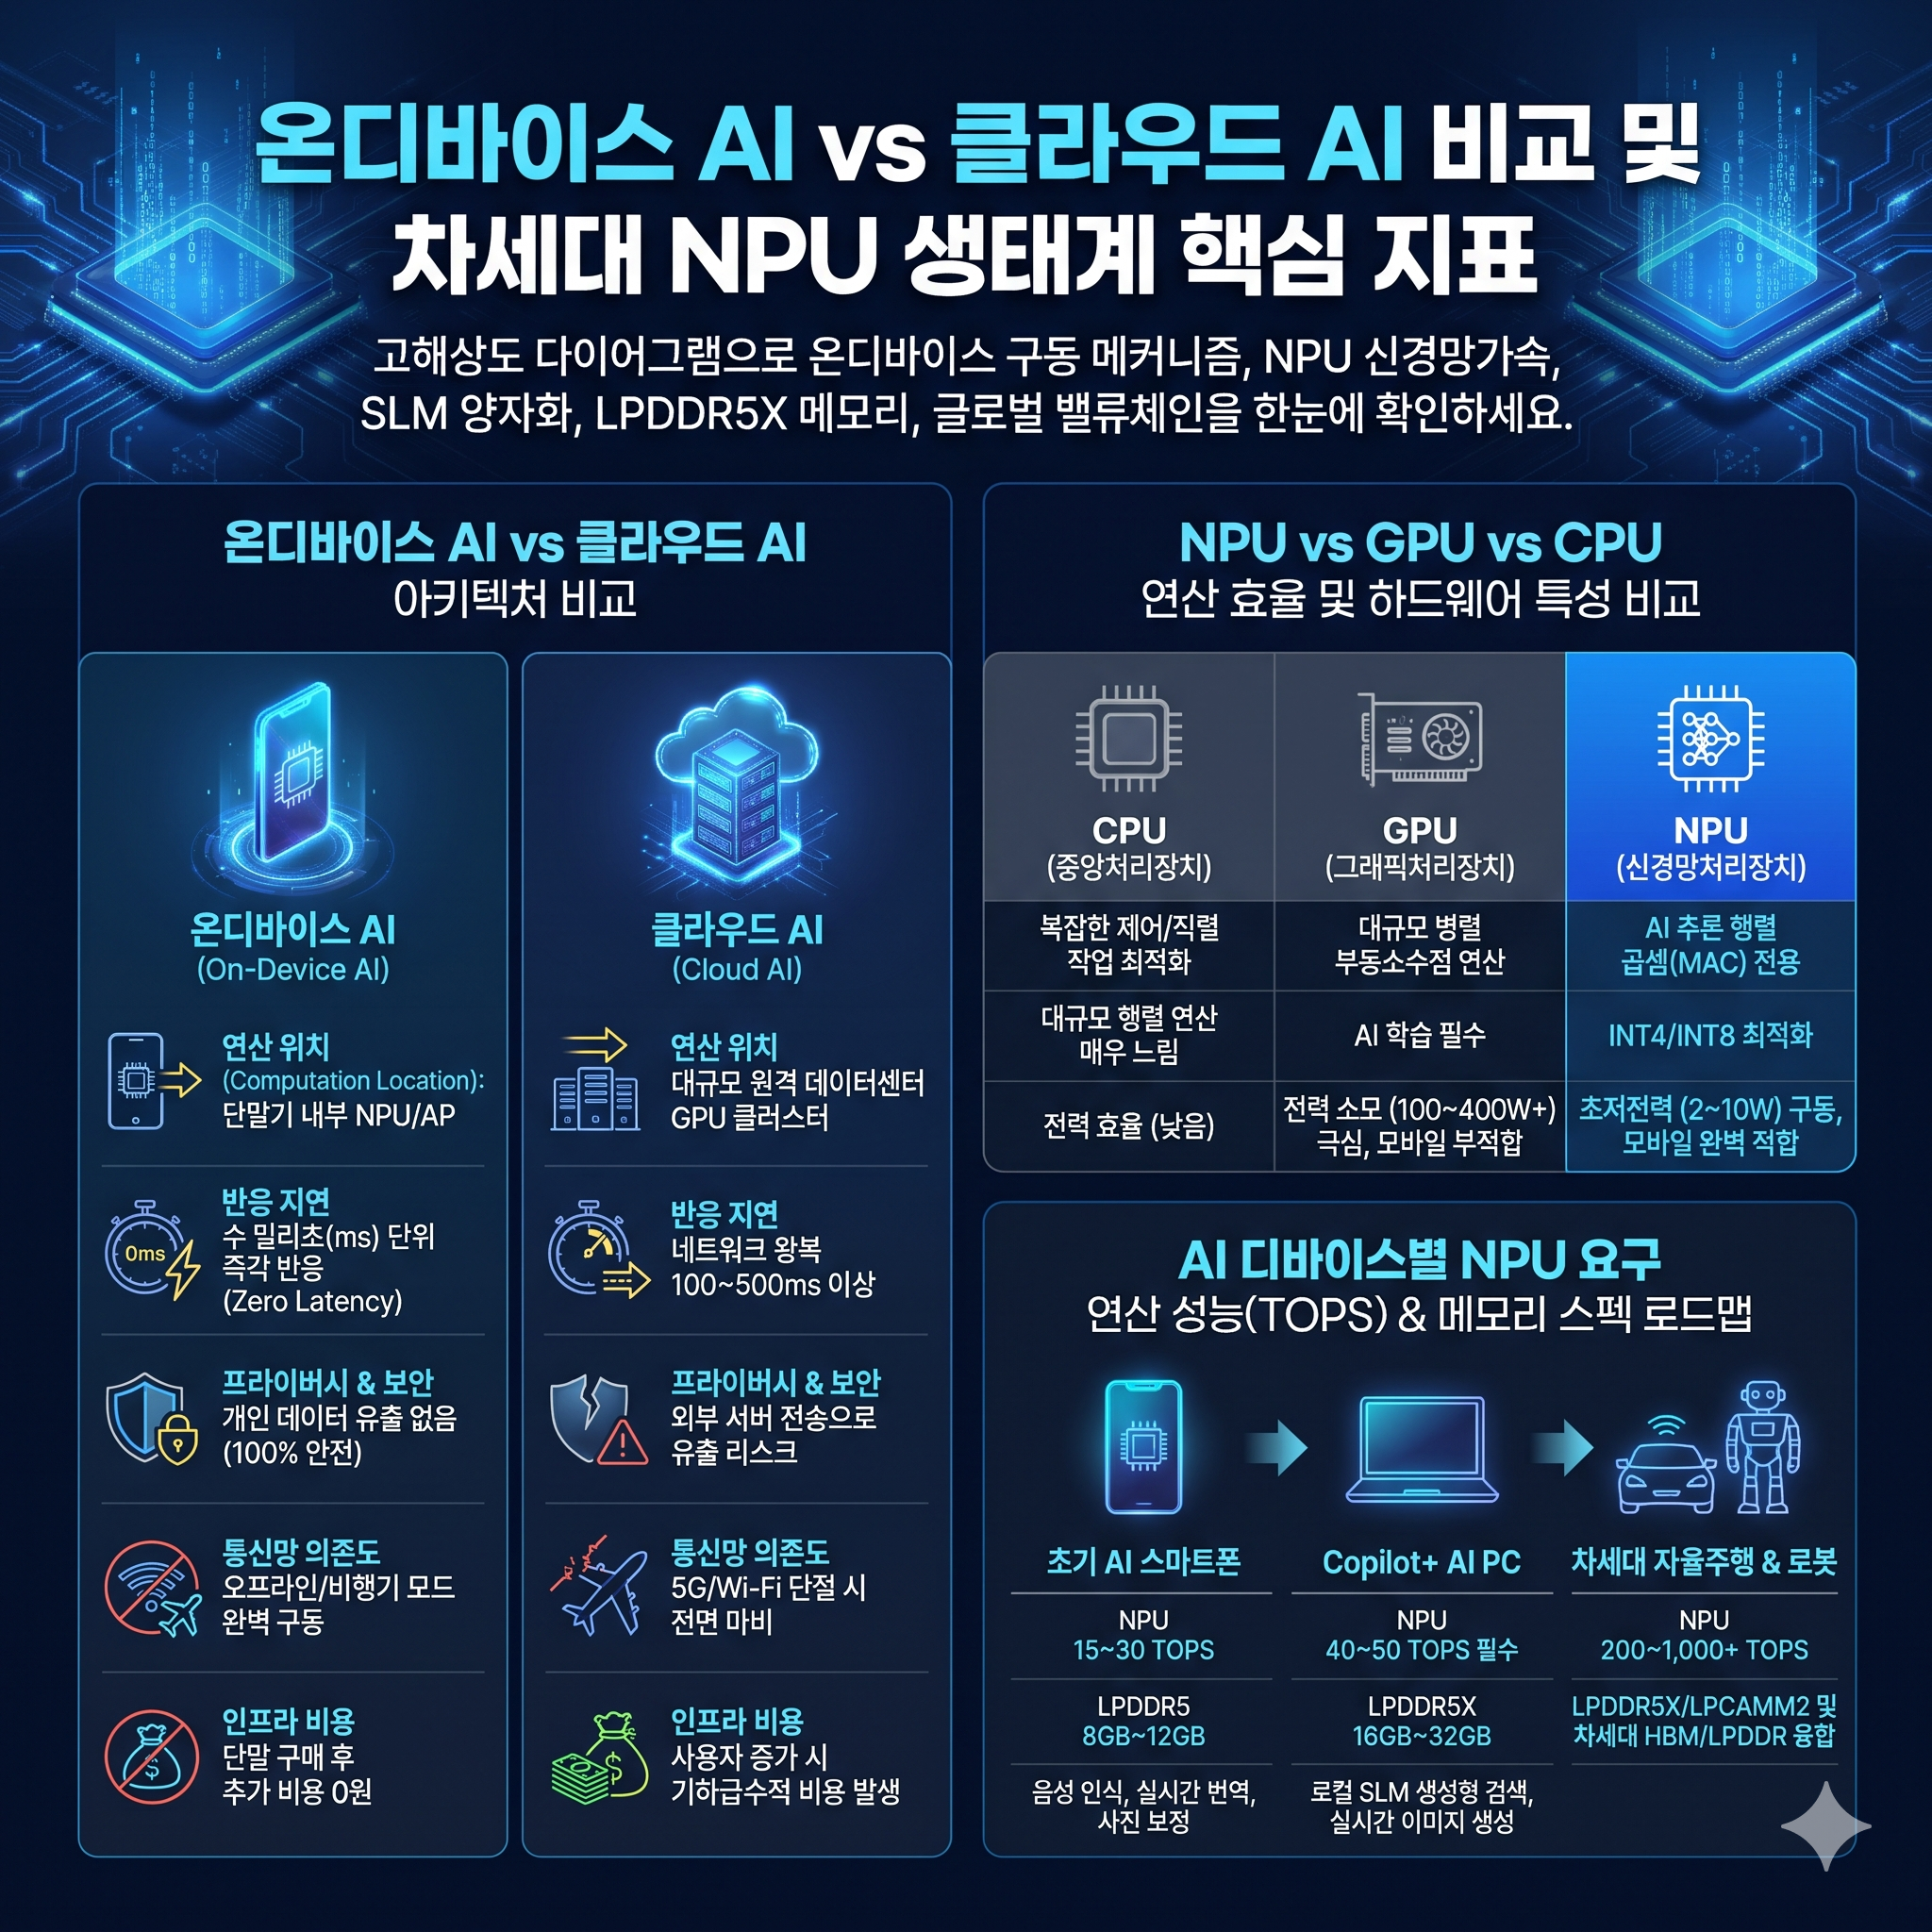
1. 온디바이스 AI 5대 핵심 기술과 동작 메커니즘 분석
작동 메커니즘: 온디바이스 AI는 중앙 클라우드 서버와 데이터를 송수신하지 않고, 사용자의 단말기(스마트폰, 태블릿, AI PC, 차량) 내부에 장착된 반도체 칩셋(AP/SoC)에서 딥러닝 추론 알고리즘을 독립적으로 직접 실행하는 기술입니다. 인터넷 연결이 차단된 비행기 안이나 지하 공간에서도 AI 기능이 완벽히 작동하며, 네트워크 왕복 시간(RTT)이 제거되어 밀리초(ms) 단위의 즉각적인 응답(Zero Latency)을 구현합니다. 또한 사용자의 민감한 금융·생체·대화 데이터가 외부 서버로 전송되지 않아 데이터 프라이버시가 완벽히 보호되며, 기업 입장에서는 천문학적인 클라우드 서버 API 통신비 및 인프라 운영 비용을 제로화할 수 있습니다.
작동 메커니즘: NPU(Neural Processing Unit)는 인간 뇌의 시냅스 연결 구조를 모방한 심층신경망(DNN) 행렬 곱셈 및 누적(MAC, Multiply-Accumulate) 연산에 100% 특화된 전용 가속 반도체입니다. 직렬 처리에 특화된 CPU나 부동소수점 그래픽 연산 중심의 GPU와 달리, NPU는 시스톨릭 어레이(Systolic Array) 구조를 통해 수천 개의 데이터를 메모리 재접근 없이 데이터 플로우 방식으로 동시 연산합니다. 이를 통해 배터리 제약이 심한 모바일·노트북 환경에서 동일 연산 성능 대비 전력 소모를 80% 이상 절감하며, 와트당 연산 능력(TOPS/W)을 극대화합니다.
작동 메커니즘: 수천억 개의 파라미터를 가진 거대언어모델(LLM)은 기가바이트(GB) 단위 메모리와 수백 와트의 전력을 소모하여 단말기에 탑재할 수 없습니다. 따라서 매개변수를 10억~70억(1B~7B) 개 수준으로 축소한 소형언어모델(SLM, Small Language Model)과 고도의 압축 알고리즘이 필수적입니다. 특히 32비트 또는 16비트 부동소수점(FP32/FP16) 가중치를 4비트나 8비트 정수(INT4/INT8)로 변환하는 양자화(Quantization), 중요도가 낮은 뉴런 연결을 가지치기하는 프루닝(Pruning), 거대 모델의 지식을 소형 모델에 전달하는 지식 증류(Knowledge Distillation)를 결합하여 정확도 손실을 1% 미만으로 억제하면서 모델 용량을 75% 축소합니다.
작동 메커니즘: 온디바이스 AI 연산의 최종 병목은 연산 속도가 아니라 메모리 대역폭(Memory Bandwidth)입니다. 매 초 수십억 번의 가중치를 NPU로 전송해야 하므로 초당 8.5Gbps~9.6Gbps 속도를 자랑하는 저전력 LPDDR5X D램이 기본 규격으로 자리 잡았습니다. 나아가 기존 메인보드 직납땜(On-board) 방식으로 인해 용량 업그레이드가 불가능했던 슬림형 노트북의 한계를 극복하기 위해, 탈부착이 가능하면서도 공간을 60% 절약하고 전력 효율을 40% 개선한 차세대 모듈 LPCAMM2(Low Power Compression Attached Memory Module 2)가 글로벌 JEDEC 표준으로 확정되었습니다.
작동 메커니즘: 온디바이스 AI는 단일 반도체를 넘어 NPU IP → 디자인하우스(DSP) → 파운드리 → 초고속 저전력 메모리 → 세트 완성품(스마트폰/PC/전장)으로 연결되는 종합 생태계입니다. 글로벌 빅테크 및 전장 기업들이 자체 맞춤형 NPU(ASIC) 개발을 추진함에 따라, 복잡한 신경망 회로를 파운드리 최신 공정에 맞춰 패키징하는 디자인 솔루션 파트너(DSP)의 역할이 시스템 경쟁력의 핵심으로 떠올랐습니다.
2. 한눈에 보는 핵심 지표 & 온디바이스 vs 클라우드 AI 비교 분석
• 반응 지연(Latency): 수 밀리초(ms) 단위 즉각 반응 (Zero Latency) vs 네트워크 왕복 100~500ms 이상 소요
• 프라이버시 & 보안: 개인 데이터가 기기 밖으로 유출되지 않음(100% 안전) vs 외부 서버 전송으로 보안 유출 리스크 상존
• 통신망 의존도: 오프라인·비행기 모드에서도 완벽 구동 vs 5G/Wi-Fi 인터넷 단절 시 AI 기능 전면 마비
• 인프라 비용: 단말 구매 후 추가 서버 비용 0원 vs 사용자 수 증가 시 기하급수적 클라우드 토큰/전력 비용 발생
• GPU(그래픽처리장치): 수천 개 코어의 대규모 병렬 부동소수점 연산 최적화, AI 학습에 필수이나 전력 소모(100~400W+) 극심하여 모바일 부적합
• NPU(신경망처리장치): AI 추론 행렬 곱셈(MAC) 전용 회로, 부동소수점 대신 INT4/INT8 최적화, 초저전력(2~10W) 구동으로 모바일·노트북 완벽 적합
• Copilot+ AI PC: NPU 40~50 TOPS 필수화, LPDDR5X 16GB~32GB 표준화 (로컬 SLM 생성형 검색, 실시간 이미지 생성)
• 차세대 자율주행 & 로봇: NPU 200~1,000+ TOPS 요구, LPDDR5X/LPCAMM2 및 차세대 HBM/LPDDR 융합 구조
3. 필수 계산 공식 & 투자 시 핵심 주의사항
요구 메모리 대역폭(GB/s) = 모델 파라미터 수(Parameters) × 양자화 비트 수(Bits / 8) × 초당 생성 토큰 수(Tokens/s)
스마트폰과 초경량 노트북은 팬이 없는 팬리스(Fanless) 구조가 많아, 온디바이스 AI 모델을 연속 실행할 경우 내부 온도가 급격히 상승합니다. 과열 방지를 위해 클록을 강제로 낮추는 스로틀링이 발생하면 AI 처리 속도가 급락하므로, 반도체 방열 설계와 NPU의 실질 전력 소모(TDP) 통제력이 실제 제품 경쟁력을 결정합니다.
애플(M시리즈/A시리즈 뉴럴엔진), 구글(텐서 TPU), 삼성전자(엑시노스 NPU) 등 세트 제조사들이 자체 NPU 설계를 강화하고 있습니다. 독자적인 아키텍처 특허나 차별화된 비디오/오디오 코덱 IP를 보유하지 못한 범용 NPU 스타트업은 공급망 진입에 어려움을 겪을 수 있어 독점적 IP 경쟁력을 확인해야 합니다.
단순 사진 보정이나 기본 통번역 수준에 머무를 경우, 소비자들이 100만~200만 원대의 고가 AI 스마트폰과 Copilot+ PC로 기기를 교체할 유인이 떨어질 수 있습니다. 오피스 생산성을 획기적으로 높이거나 OS와 완전 결합된 킬러 서비스의 등장 여부가 디바이스 출하량 성장세를 좌우합니다.
4. 온디바이스 AI & NPU 실전 투자 5단계 체크리스트
5. 투자자 실무 핵심 FAQ
2. 차세대 NPU는 행렬 곱셈(MAC)에 특화된 시스톨릭 아키텍처로 CPU/GPU 대비 전력 효율을 80% 끌어올린 AI PC·스마트폰의 심장입니다.
3. SLM 및 4비트 양자화는 1B~7B 크기의 소형 모델을 정확도 저하 없이 75% 압축하여 모바일 하드웨어 탑재를 가능하게 합니다.
4. LPDDR5X & LPCAMM2는 초당 9.6Gbps 고대역폭과 탈부착 저전력 혁신으로 온디바이스 메모리 전송 병목을 완벽히 해소합니다.
5. 글로벌 생태계는 빅테크의 기기 혁신과 더불어 국내 NPU IP, 디자인하우스, 모바일 메모리 밸류체인의 동반 수혜를 견인합니다.
'경제&주식 > 용어정리' 카테고리의 다른 글
| [주식&경제용어] 바이오와 표적항암제 밸류체인 (2편) - 차세대 표적항암제와 ADC 링커·페이로드 생태계 및 핵심 요약 (0) | 2026.10.25 |
|---|---|
| [주식&경제용어] 바이오와 비만치료제 밸류체인 (1편) - 차세대 GLP-1 비만치료제와 펩타이드 생태계 요약 (0) | 2026.10.24 |
| 로봇과 피지컬 AI 밸류체인 (2편) - 로봇 파운데이션 모델(VLA)과 자율 제조 생태계 (0) | 2026.10.21 |
| 로봇과 피지컬 AI 밸류체인 (1편) - 휴머노이드 로봇 액추에이터와 정밀 감속기 생태계 (0) | 2026.10.20 |
| 원자력과 차세대 SMR 밸류체인 (2편) - 글로벌 원전 시공·BOP 소부장 심층 생태계 및 핵심 요약 (0) | 2026.10.14 |


